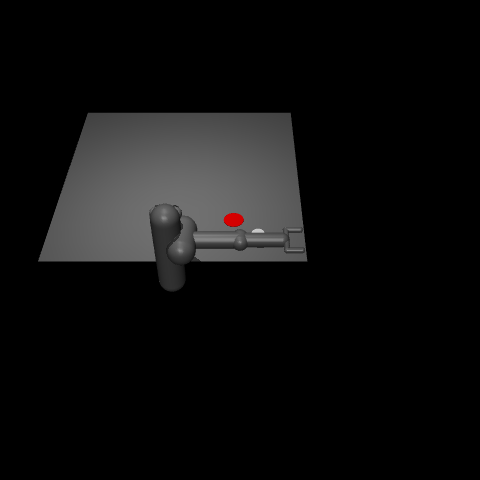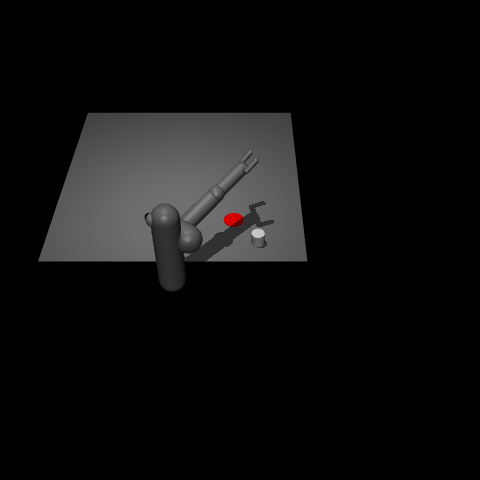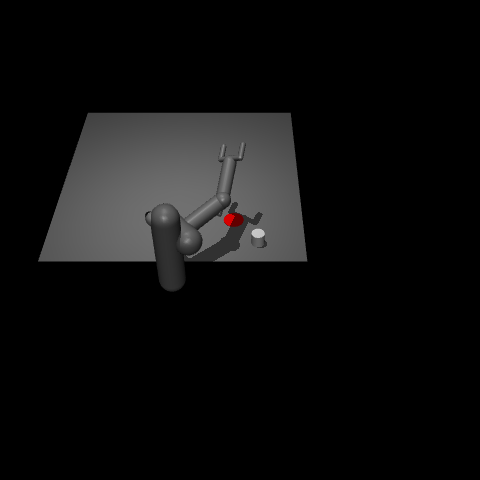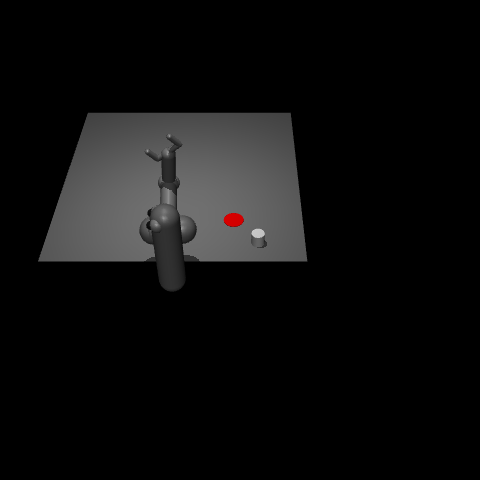
RL ist in der Praxis oft datenintensiv und empfindlich gegenüber Hyperparametern, Belohnungsdefinitionen und Zufall. Im Vergleich zu Supervised Learning benötigt es häufig deutlich mehr Interaktionen mit der Umgebung und das Training kann instabiler sein.
Grundlegende Konzepte
Reinforcement Learning basiert auf einer iterativen Lernstrategie, bei der die Qualität der Lösung durch positives oder negatives Feedback bewertet wird. Das RL-Modell wird hierbei als Agent gesehen, der mit der Umgebung interagiert. Die Begriffe in diesem Kontext sind:
Agent: Der Lernende oder Entscheidungsträger, der in der Umgebung agiert.
Umgebung (Environment): Alles, mit dem der Agent interagiert.
Aktion (Action): Eine Entscheidung oder Bewegung, die der Agent treffen kann.
Belohnung (Reward): Rückmeldung aus der Umgebung, die angibt, wie gut eine Aktion im gegebenen Zustand war.
Wertfunktion (Value Function): Eine Funktion, die angibt, wie gut ein bestimmter Zustand oder eine Aktion ist.
Strategie (Policy): Eine Strategie, die der Agent verwendet, um Aktionen zu wählen basierend auf dem Zustand und der Wertfunktion.
Zustand (State): Eine Repräsentation der aktuellen Situation der Umgebung und ggf. der Strategie.
Komponenten und Begriffe beim Reinforcement Learning
Zur Modellierung der Umgebung und aktuellen Strategie verwendet man im RL oft ein Markov Decision Process (MDP). Das ist ein diskretes Zustandsmodell, bei dem das System sich immer nur in einem einzigen Zustand befinden kann, der die Umgebung widerspiegelt. Jeder Zustand beschreibt eine bestimmte Bedingung oder Position im Verhalten des Systems. Auf Basis des aktuellen Zustands und der gewählten Aktion erzeugt die Umgebung den nächsten Zustand sowie eine Belohnung.
Markov-Modelle sind eine sehr beliebte Modelltyp im Maschinellen Lernen. Sie basieren alle auf der Markov-Bedingung, dass die Übergangswahrscheinlichkeit von einem Zustand in den anderen nur von dem aktuellen Zustand abhängt und nicht vorhergehenden Zuständen (es gibt also keine Autokorrelation). Man spricht dabei auch von der Gedächtnislosigkeit. Dies basiert auf der Idee, dass der Zustand des Systems zu einem bestimmten Zeitpunkt alle Informationen enthält, die notwendig sind, um sein zukünftiges Verhalten vorherzusagen.
Ein MDP besteht aus:
\(S\): Menge aller möglichen Zustände.
\(A\): Menge aller möglichen Aktionen.
\(P(s'|s, a)\): Übergangswahrscheinlichkeit vom Zustand \(s\) zum Zustand \(s'\) bei Aktion \(a\).
\(R(s, a)\): Belohnungsfunktion, die die Belohnung angibt, die der Agent erhält, wenn er im Zustand \(s\) die Aktion \(a\) ausführt.
\(\gamma\): Diskontierungsfaktor, der zukünftige Belohnungen abwertet.
Beispiel eines MDP Zustandsdiagrams mit drei Zuständen
Eine wichtige Gleichung ist hierfür die Bellman-Gleichung. Sie beschreibt die Beziehung zwischen dem aktuellen Zustands-Aktionspaar \((s,a)\), der beobachteten Belohnung und den möglichen Nachfolge-Zustands-Aktionspaaren \(s',a'\). Diese Beziehung wird verwendet, um die optimale Wertfunktion zu finden.
\[
V(s) = \max_a \left( R(s, a) + \gamma \sum_{s'} P(s'|s, a) V(s') \right)
\]
Diese Gleichung besagt, dass der optimale Wert eines Zustands \(s\) die maximale erwartete Belohnung ist, die der Agent erhalten kann, wenn er im Zustand \(s\) startet, die Aktion \(a\) wählt und danach der optimalen Policy folgt. Dadurch berücksichtigen wir bei der Bewertung des Zustandsüberganges durch die Aktion \(a\) nicht nur den aktuellen Zustand, sondern auch die durch Aktion \(a\) ermöglichten zukünftigen Zustandsübergänge. Damit lösen wir das Dilemma der Gedächtnislosigkeit, das aus der Markov-Bedingung folgt.
Die Wertfunktion \(V(s)\) bewertet einen Zustand insgesamt. Die Q-Funktion \(Q(s,a)\) bewertet dagegen eine konkrete Aktion in einem Zustand. \(Q(s,a)\) ist damit für die Aktionsauswahl oft direkter nutzbar, weil man die beste Aktion über das Maximum der Q-Werte bestimmen kann [Bellman, 1957].
Die Bellman-Gleichung wird genutzt, um die optimale Strategie in Form einer Q-Funktion\(Q(s,a)\) im Q-Learning zu erlernen. Das ist ein populärer Off-Policy-Algorithmus, bei dem der Agent eine Q-Funktion \(Q(s, a)\) lernt, welche Belohnungen einer Aktion \(a\) in einem Zustand \(s\) erwartet wird. Off-Policy bedeutet hier, dass das Update den aktuell besten geschätzten nächsten Q-Wert verwendet, auch wenn die tatsächlich ausgeführte Aktion aufgrund von Exploration eine andere war.
\[
Q(s, a) \leftarrow Q(s, a) + \alpha \left( R(s, a) + \gamma \max_{a'} Q(s', a') - Q(s, a) \right)
\]
hierbei stellt \(\alpha\) die Lernrate dar. Die ist ein sehr wichtiger Parameter, da er bestimmt, wie stark jedes einzelne Update die Q-Werte verändert. Ein niedriger Wert verlangsamt alle Updates und erfordert dadurch längeres Training bis zur Konvergenz. Ein hoher Wert kann dagegen zu instabilen, stark schwankenden Updates führen, sodass das Modell bereits gelernte Werte überschreibt und nicht zuverlässig konvergiert.
Deshalb kombiniert man den Algorithmus man meist mit einer Erkundungsstrategie. Statt immer nur die geschätzte optimale Strategie \(Q(s,a)\) zu nehmen, wählt man mit der Wahrscheinlichkeit \(\epsilon\) zufällige Strategien aus, um somit alternative Strategien zu entdecken. Ein hoher \(\epsilon\)-Wert sorgt für eine hohe Erkundungsrate (Exploration), während ein niedriger ein verlässlichere Vorhersage erlaubt. Um hier einen Trade-Off zu finden, macht man oft beides und wählt am Anfang des Trainings ein hohes \(\epsilon\), um den Lösungsbereich zu erkunden und am Ende des Trainings ein niedriges \(\epsilon\) um schneller und verlässlicher zu konvergieren.
Beispiel: Gridworld-Umgebung
Wir werden eine einfache Gridworld-Umgebung verwenden, um die Grundprinzipien von Reinforcement Learning zu veranschaulichen. In dieser Umgebung versucht ein Agent, in einem Grid von einem Startzustand zu einem Zielzustand zu gelangen und dabei den kürzesten Weg zu finden.
Dies kann zum Beispiel zur Steuerung eines Materialtransports auf einer Baustelle dienen. Ein Agent (z.B. ein Bagger) befindet sich auf einer vereinfachten Baustelle und muss Material von einer Quelle zu einem Zielbereich bringen. Wir simulieren dieses Szenario in einer Gitterwelt mit folgenden Regeln:
Der Agent kann sich hoch, runter, links, rechts bewegen.
Er erhält +1 Punkt, wenn er das Ziel (Z) erreicht.
Für jeden Schritt wird er mit -0.1 Punkten bestraft.
Die Umgebung ist sehr einfach und zufallsbasiert.
Wir erstellen uns als erstes eine Klasse, welche die Umgebung repräsentiert und die Zustände enthält. Die Umgebung initialisiert zuerst unser Raster (Grid) mit der Start- und Endposition. Dieses Raster definiert unseren Zustandsraum, da der Agent, wenn er sich fort bewegt sich in jeder dieser Zellen im Raster aufhalten kann.
Damit wir Experimente beim Lernen wiederholen können gibt es eine reset-Funktion. Mit der step-Funktion kann der Agent sich fortbewegen. Wir übergeben der Funktion als action die Richtung, in der wir uns bewegen wollen. Dadurch wechselt sich die aktuelle Position, also der aktuelle Zustand in unserem Zustandsmodell.
Code
import numpy as np # Import von NumPy# Definition der Gridworld-Umgebungclass Gridworld:def__init__(self, size, start, goal):self.size = sizeself.start = startself.goal = goalself.state = startself.actions = ['up', 'down', 'left', 'right']self.grid=np.zeros((self.size,self.size))self.grid[start]=1self.grid[goal]=-1def reset(self):self.state =self.startreturnself.statedef step(self, action): x, y =self.stateif action =='up': x =max(0, x -1)elif action =='down': x =min(self.size -1, x +1)elif action =='left': y =max(0, y -1)elif action =='right': y =min(self.size -1, y +1)self.state = (x, y)self.grid[self.state]+=1 reward =1ifself.state ==self.goal else-0.1 done =self.state ==self.goalreturnself.state, reward, done
Erstellen wir uns als Beispiel ein 3x3 Gridworld und wollen uns vom Punkt \((0,0)\) zum Punkt \((3,3)\) bewegen.
Bewegen wir uns einmal manuell durch das Grid, so sehen wir wie die Zustände (unsere Position) sich ändern und welche Belohnungen wir erhalten. Wichtig hierbei ist, dass wir eine positive Belohnung erst beim letzten Schritt erhalten, vorher immer nur bestraft werden (z.B. Erschöpfung).
# Beispiel für einen Schritt in der Umgebungsteps=['right','down','right','down','right','down']for step in steps: next_state, reward, done = env.step(step)print("Nächster Zustand:", next_state, "Belohnung:", reward, "Ziel erreicht:", done)
Nächster Zustand: (0, 1) Belohnung: -0.1 Ziel erreicht: False
Nächster Zustand: (1, 1) Belohnung: -0.1 Ziel erreicht: False
Nächster Zustand: (1, 2) Belohnung: -0.1 Ziel erreicht: False
Nächster Zustand: (2, 2) Belohnung: -0.1 Ziel erreicht: False
Nächster Zustand: (2, 3) Belohnung: -0.1 Ziel erreicht: False
Nächster Zustand: (3, 3) Belohnung: 1 Ziel erreicht: True
import plotly.express as pxpx.imshow(env.grid, color_continuous_scale="Blues").update_xaxes(showticklabels=False, ticks="", title=None).update_yaxes(showticklabels=False, ticks="", title=None)
Random Walk
Ein naiver Lösungsansatz ist der so genannte Random Walk (Zufallsweg), bei dem man bei jedem Schritt in eine zufällig gewählte Richtung läuft, was auch bedeutet, dass man ggf. zurück läuft. Untersuchen wir einmal in 300 Experimenten die Erfolgsrate dieser Lösungsstrategie.
env = Gridworld(size=4, start=(0, 0), goal=(3, 3))trials =300rewards = []retries = []for trial inrange(trials): env.reset() n, r_sum =0, 0 done =Falsewhilenot done:# Wir wählen eine zufällige Aktion action = np.random.choice(env.actions)# Führe die Aktion aus und erhalte von der Umgebung den neuen Zustand und die Belohnung new_state, reward, done = env.step(action)# Sammel Erfolgsstatistik r_sum += reward n +=1 rewards.append(r_sum) retries.append(n)
Die folgende Animation zeigt, wie sich die besuchten Zustände über die ersten 20 Episoden Schritt für Schritt aufbauen, bevor wir danach jeweils 10 Episode überspringen. Man sieht, dass der Random-Walk-Agent keine Lernkurve hat, sondern immer wieder zurück läuft.
Wenn wir uns die resultierende Häufigkeit der besuchten Rasterpunkte ansehen, so zeigt sich, dass der Großteil der Versuche um dem Starpunkt herum hängen bleibt, aufgrund des Zurücklaufens.
In allen Experimenten ist unser Agent zum Ziel gekommen, was zeigt, dass diese zufällige Explorations-Strategie durchaus erfolgreich ist. Schauen wir auf die Anzahl der Versuche bis zum Ziel über unsere Experimente, so sehen wir, dass diese gleichbleibend stark variiert. Wir haben also kein Lerneffekt.
import plotly.express as pxpx.line(retries)
Entsprechend niedrig sind auch die Belohnungen, die das Programm pro Experiment sammelt.
px.scatter(y=rewards, trendline="lowess")
Q-Learning
Im Gegensatz zum Random Walk, der kein Gedächtnis hat und daher nie besser wird, lernt Q-Learning aus jeder Interaktion: Die Q-Werte verbessern sich iterativ, sodass der Agent nach und nach kürzere Wege bevorzugt.
Wir implementieren als nächstes den Q-Learning Ansatz wie er oben beschrieben worden ist. Hierfür initialisieren wir als erstes die Q-Matrix, in welcher wir die erlernten Q-Werte speichern. Da unser Zustandsraum die Größe 4x4 hat und wir 4 Aktionen haben, hat die Q-Matrix eine Größe von 4x4x4.
Der Q-Learning Algorithmus besteht nun zum einen in der Möglichkeit mit der Wahrscheinlichkeit \(\epsilon\) ein explorativen zufälligen Schritt zu machen oder den vielversprechendsten Schritt unseres aktuellen Zustands \(s_1,s_2\) mit dem maximalen Q-Wert (argmax).
Code
env = Gridworld(size=4, start=(0, 0), goal=(3, 3))# Initialisiere Q-WerteQ = np.zeros((env.size, env.size, len(env.actions)))# Hyperparameteralpha =0.2# Lernrategamma =0.9# Diskontierungsfaktorepsilon =0.1# Epsilon für die Epsilon-Greedy-StrategierewardsQ=[]retriesQ=[]for trial inrange(trials): state = env.reset() done =False n, r_sum=0, 0whilenot done:if np.random.uniform(0,1) < epsilon:# Wähle Aktion entweder Zufällig aus action = np.random.randint(0, len(env.actions))else:# Wähle Aktion mit maximaler erwarteten Belohnung Q(s) action = np.argmax(Q[state[0], state[1], :])# Führe die Aktion aus und erhalte von der Umgebung den neuen Zustand und die Belohnung new_state, reward, done = env.step(env.actions[action])# Aktualisiere Q-Werte auf Basis der erhaltenen Belohnung Q[state[0], state[1], action] += alpha * (reward + gamma * np.max(Q[new_state[0], new_state[1], :]) - Q[state[0], state[1], action])# Aktualisiere den Zustand state = new_state# Sammel Erfolgsstatistik r_sum+=reward n +=1 rewardsQ.append(r_sum) retriesQ.append(n)
Wenn wir nun die Wiederholungsversuche uns ansehen, dann sehen wir, dass diese schnell auf das Minimum von nur 6 Schritten abfallen. Die verbleibenden Schwankungen entstehen durch den Zufallsanteil \(\epsilon\) der \(\epsilon\)-Greedy-Strategie — das ist gewollt, damit der Agent weiterhin gelegentlich andere Wege erkundet und nicht dauerhaft auf einem einzigen Pfad verharrt.
px.line(retriesQ)
Betrachten wir die Belohnungen, so sehen wir, dass der Ansatz sehr schnell nur noch positive Belohnungen erzieht.
px.scatter(y=rewardsQ, trendline="lowess")
Die folgende Animation zeigt den Q-Learning-Lernprozess: Jeder Frame zeigt die akkumulierten Besuche nach \(N\) Trainingsepisoden sowie die aktuelle Greedy-Strategie als Pfeile. Es lässt sich erkennen, wie sich diese von zunächst zufälligen zu immer gerichteteren Pfeilen entwickelt.
Die Besuchhäufigkeit zeigt, dass der Lernansatz einen der optimalen Wege findet und diesen wiederholt.
Mit Reinforcement Learning kann man auch Modelle auf Zeitreihen trainieren. Wir wollen uns zum Beispiel einen Entscheidungsalgorithmus trainieren, welcher lernt, wann er Long-Positionen aufbauen oder Short-Positionen eröffnen soll und wann er sie auflösen soll. Hier ein zufälliger Aktienkurs.
Wir definieren uns wieder eine Trainingsumgebung. Dieses Mal haben wir allerdings die Schwierigkeit, dass der Wert kontinuierlich sind und nicht diskret, wir also keine natürliche Zustandsraumdarstellung haben. Deshalb müssen wir die kontinuierliche Zeitreihe des Aktienwertes zuerst diskretisieren.
Als Beispiel kaufen wir Aktien, halten sie für 6 Züge und verkaufen sie. Dann kaufen wir Shorts, um auf fallende Aktien zu wetten, halten sie wieder und verkaufen sie.
num_states=40# Beispiel für die Erstellung und Verwendung der StockTradingEnv-Umgebungenv = StockTradingEnv(data, num_states)state = env.reset()print("Startzustand:", state)# Beispiel für einen Schritt in der Umgebungfor action in [2,1,1,1,1,1,0,0,1,1,1,1,1,2]:# 2 = Kaufen, 1 = Halten, 0 = Verkaufen next_state, reward, done = env.step(action) print("Nächster Zustand:", next_state, "Belohnung:", reward, "Ziel erreicht:", done)
Startzustand: 40
Nächster Zustand: 41 Belohnung: 0 Ziel erreicht: False
Nächster Zustand: 44 Belohnung: 0 Ziel erreicht: False
Nächster Zustand: 53 Belohnung: 0 Ziel erreicht: False
Nächster Zustand: 53 Belohnung: 0 Ziel erreicht: False
Nächster Zustand: 50 Belohnung: 0 Ziel erreicht: False
Nächster Zustand: 59 Belohnung: 0 Ziel erreicht: False
Nächster Zustand: 64 Belohnung: 9.298151214993005 Ziel erreicht: False
Nächster Zustand: 60 Belohnung: 0 Ziel erreicht: False
Nächster Zustand: 66 Belohnung: 0 Ziel erreicht: False
Nächster Zustand: 63 Belohnung: 0 Ziel erreicht: False
Nächster Zustand: 60 Belohnung: 0 Ziel erreicht: False
Nächster Zustand: 63 Belohnung: 0 Ziel erreicht: False
Nächster Zustand: 54 Belohnung: 0 Ziel erreicht: False
Nächster Zustand: 46 Belohnung: 6.365646416803102 Ziel erreicht: False
Als nächstes implementieren wir wieder den Q-Learning Algorithmus. Der ist fast identisch zu dem Gridworld-Beispiel. Unterschiede gibt es nur, da wir nur eine zweidimensionale Q-Matrix haben, statt einer dreidimensionalen, da der Zustandsraum weniger Dimensionen hat.
Code
import time# Beispiel für die Erstellung und Verwendung der StockTradingEnv-Umgebungtic=time.time()env = StockTradingEnv(data, num_states)# Initialisiere Q-WerteQ = np.zeros((num_states *3, 3)) # Zustände: price_bin × 3 Positionen# Hyperparameteralpha =0.1# Lernrategamma =0.9# Diskontierungsfaktorepsilon =0.1# Epsilon für die Epsilon-Greedy-Strategie# Training des Q-Learning-Agentenrewards = []for episode inrange(2000): state = env.reset() done =False total_reward =0whilenot done:if np.random.random() < epsilon:# Wähle Aktion entweder Zufällig aus action = np.random.randint(0, len(env.actions))else:# Wähle Aktion mit maximaler erwarteten Belohnung Q(s) action = np.argmax(Q[env.state])# Führe die Aktion aus und erhalte von der Umgebung den neuen Zustand und die Belohnung new_state, reward, done = env.step(action)# Aktualisiere Q-Werte auf Basis der erhaltenen Belohnung Q[state, action] += alpha * (reward + gamma * np.max(Q[new_state]) - Q[state, action]) state = new_state total_reward += reward rewards.append(total_reward)print(f"Execution Time: {time.time()-tic}")
Auch hier zeigt sich, dass der Q-Learning Algorithmus auf diesem synthetischen Datensatz lernt, Kauf- und Verkaufssignale zuzuordnen. Zu beachten ist, dass dies ein vereinfachtes Spielzeugbeispiel ist: Die Kursdaten sind zufällig generiert, es gibt keine Transaktionskosten, und die Ergebnisse lassen sich nicht auf reale Märkte übertragen.
px.scatter(y=rewards, trendline="lowess")
Hierbei macht der Algorithmus gar nicht so viele Transaktionen, wie er könnte, um das Ergebnis zu maximieren.
from plotly.subplots import make_subplotsimport plotly.graph_objects as gofig = make_subplots(rows=2, cols=1, shared_xaxes=True, subplot_titles=("Portfoliowert", "Aktionen (1=Kaufen, 0=Halten, -1=Verkaufen)"))fig.add_trace(go.Scatter(y=portfolio, name="Portfolio"), row=1, col=1)fig.add_trace(go.Scatter(y=[a-1for a in actions], line_shape="hvh", name="Aktion"), row=2, col=1)fig.show()
RL Frameworks
Das Standard-Interface in Gym für eine Umgebung für den Börsenfall ist mehr oder weniger identisch mit der Klasse, die wir oben definiert haben.
Ein Aspekt warum RL in den letzten Jahren so beliebt geworden ist, ist dass sich der Lernvorgang gut parallelisieren lässt. Da wir zum Lernen viele Experimente machen müssen, können wir diese natürlich auch parallel ausführen und dadurch gut in einem Rechenzentrum in der Cloud oder auf Grafikkarten mit ihren tausenden kleinen Prozessoren verteilen.
Eine Bibliothek, die hierbei viel genutzt wird, ist Ray welche auch gerne zur Parallelisierung von ML-Aufgaben genutzt wird, da die Bibliothek das Verteilen der Lernaufgaben im Cluster und das Sammeln der Ergebnisse übernimmt.
Wir nutzen hier den Proximale Policy Optimization (PPO) Algorithmus. Er ist ein iteratives Verfahren, welches zur Optimierung von Richtlinien in Agenten verwendet wird und instabile Updates der Policy vermeidet und ermöglicht so die effiziente Handhabung komplexer Aufgaben mit kontinuierlichen Aktionsräumen. Dies wird durch die Einführung eines Clip-Parameters ε erreicht, der die maximale Änderung der Policy-Parameter begrenzt. PPO ist ein On-Policy-Verfahren, weil die Policy mit Daten aktualisiert wird, die von der aktuellen Policy selbst erzeugt wurden.
fig = make_subplots(rows=2, cols=1, shared_xaxes=True, subplot_titles=("Portfoliowert", "Aktionen (1=Kaufen, 0=Halten, -1=Verkaufen)"))fig.add_trace(go.Scatter(y=portfolio, name="Portfolio"), row=1, col=1)fig.add_trace(go.Scatter(y=[a-1for a in actions], line_shape="hvh", name="Aktion"), row=2, col=1)fig.show()
Robotik
DL ist insbesondere in der Robotik ein beliebtes Lernverfahren. Das liegt daran, das zum einen einfache Aufgaben, wie das Greifen von Objekten für Roboter hochkomplex sind und die Regelungen und Steuerungen sehr komplex zu entwickeln sind. Auch wir Menschen brauchen Wochen als Kleinkind um die Grob- und Feinmotorik dafür zu lernen. Trotzdem ist die Aufgabe und die Umgebung eines Roboters einfach zu simulieren. Deshalb setzt man vermehrt auf RL, um solche komplexen Steuerungsprobleme zu erlernen, statt selbstständisch Steuerungen zu entwickeln.
Robot Pusher
Pusher-v5 ist eine Umgebung aus der Gymnasium-Bibliothek, die zur Simulation von Aufgaben im Bereich der Robotersteuerung verwendet wird. In dieser speziellen Umgebung wird ein Roboterarm simuliert, der darauf trainiert wird, ein Objekt zu einer bestimmten Zielposition zu schieben.
Da das Modell in Gym enthalten ist, ist die Initialisierung einfach.
Betrachten wir einmal das Ergebnis einer zufälligen Bewegung, so sehen wir wie der Arm vorerst orientierungslos agiert.
Nach mehreren Trainingsepisoden lernt der Algorithmus allerdings den Arm gut zu benutzen. Hier ein Vergleich unterschiedlicher RL-Ansätze. Zu beobachten ist, dass über die Trainings-Episoden die Modelle durch Zufall die Lösung entdecken und dann wiederholen können. Die finalen Lösungen sind dabei aber auch nach vielen Trainings-Episoden nicht perfekt.
#| echo: falsefrom IPython.display import IFrameIFrame(width="800", height="413", src="https://www.youtube.com/embed/_QmcH1TyNwg", title="Gymnasium - Pusher-v4, Test with different algorithms", frameborder="0", allow="accelerometer; autoplay; clipboard-write; encrypted-media; gyroscope; picture-in-picture; web-share", referrerpolicy="strict-origin-when-cross-origin", allowfullscreen=True)
Acrobot
Acrobot-v1 ist eine klassische Gymnasium-Umgebung, in der ein zweigliedriges Pendelsystem durch geeignete Steuerimpulse in eine aufrechte Position gebracht werden soll.